Candidatos dinâmicos não são nenhuma novidade para o motor de assignment manager do Siebel, isso é fato. Outro fato é que muitos projetos de desenvolvimento relacionados ao assunto poderiam ter escopo reduzido se a feature fosse utilizada com mais frequência.
Em linhas gerais o que são candidatos dinâmicos?
Um candidato é uma da entidade, geralmente um usuário, funcionário, contato, posição, organização ou time, considerado pelo motor de atribuição do Siebel CRM no momento de distribuir um objeto.
Um candidato não dinâmico é um candidato estático!
“_Dãaa!”
Eu sei, eu sei. Meio óbvio. Mas as vezes o óbvio precisa ser dito.
O importante aqui é saber que um candidato estático é estático na regra de distribuição, ou seja, sempre que há alguma modificação no conjunto de candidatos estáticos a regra precisa ser alterada.
Já os candidatos dinâmicos são candidatos dinâmicos porque variam em função do objeto que está sendo atribuído (Service Request, Opportunity, Activity, Lead ou qualquer outra entidade que se queira distribuir entre candidatos).
Exemplos:
- Uma empresa que precisa distribuir Expense Reports para um time financeiro que tem 4 funcionários, poderia fazer uma regra com 4 funcionários estáticos (candidatos). Se um dia houver uma modificação no time (demissão, contratação, aposentadoria), a regra precisaria ser alterada.
- Agora, uma empresa que precisa distribuir Expense Reports para times financeiros que variam dependendo do país onde o expense foi faturado, do idioma do criador do expense ou do valor do expense poderia utilizar candidatos dinâmicos para facilitar o trabalho.
É possível atingir o objetivo do exemplo 2 sem usar candidatos dinâmicos? Sim, é possível!
Contudo, invariavelmente as alternativas ao uso de candidatos dinâmicos exigirão duplicação de regras, replicação de times, manutenções periódicas mais frequentes, uso de atributos dinâmicos deixando a manutenção da engine do Assignment Manager muito mais complexa.
Sob a minha ótica, o uso de candidato dinâmico reduz a complexidade da solução como um todo, desde a concepção, passando pelo desenvolvimento, até a manutenção, que geralmente fica na mão dos usuários administradores do CRM.
Estudo de Caso Real
Um cliente da Troubleshooter IT que acabara de findar um contrato de prestação de serviço com uma consultoria concorrente tinha uma necessidade de distribuição de chamados.
As necessidades do cliente eram, em resumo:
Ter 3 níveis de status e de donos do chamado (nesse artigo vamos nos referir a chamado como Service Request algumas vezes);
O chamado poderia subir ou descer de nível e mudar de dono dependendo do Status. Entenda o nível como o grau de escalamento do chamado, ou seja, quanto maior o nível, mais escalado ele está e, portanto, mais alta é função do usuário que é dono desse chamado;
Cada combinação de nível/status e tipo de chamado teria seus próprios candidatos. Por exemplo, um chamado com status “Pendente” escalado para o “Segundo Nível”, só poderia ser distribuído para grupos específicos de usuários que atendem em turnos específicos;
Deveriam existir turnos de atendimento, ou seja, os candidatos variariam conforme o momento de criação ou atualização do status;
Os turnos mudariam conforme o nível e tipo de chamado de chamado;
Os chamados não resolvidos ou finalizados deveriam ser redistribuídos sempre que houvesse troca de turno;
Um mesmo candidato poderia atender em mais de um turno ao mesmo tempo;
Poderiam coexistir turnos numa mesma faixa de horário e, nesse caso, os candidatos dos turnos precisariam ser combinados durante essa faixa de horário comum;
Turnos poderiam começar num dia e terminar no outro dia;
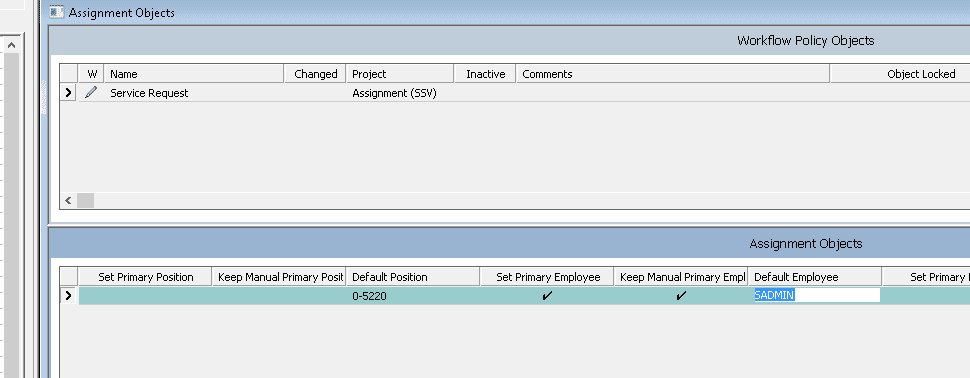
Em faixas de horário sem turno, os chamados deveriam permanecer atribuídos aos respectivos donos atuais e, caso não tivessem nenhum usuários associado, deveriam ser atribuídos ao SADMIN;
Alguns tipos de chamado precisariam ser distribuídos proporcionalmente considerando a carga de trabalho de cada candidato, enquanto a maioria dos tipos de chamado poderia ser distribuído entre os candidatos do turno de forma aleatória;
Os turnos podem cobrir alguns dias da semana específicos – finais de semana ou dias úteis – ou todos os dias da semana ou dias intercalados da semana.

Parece complicado reverter essas regras pro CRM? Sim, parece. É complicado reverter essas regras para o CRM? Depende.
A proposta inicial, feita pela antiga fábrica de desenvolvimento, contemplava:
Um escopo de quase 50 páginas; +20 regras de distribuição; Troca de candidatos estáticos nas regras através processamento batch; Uns 20 applets de cadastros diferentes; Botãozinho aqui e ali; Entre outras funcionalidades no mínimo desnecessárias.
Respeitosamente, preferimos seguir por um caminho divergente do legado pela nossa concorrente.
Nossa proposta Para Assignment Manager com Candidatos Dinâmicos
Atender o máximo das necessidades do cliente no mínimo tempo possível;.
Manter as configurações envolvidas fáceis de serem ajustadas (começa simples e adiciona complexidade aos poucos);
Mínimo de treinamento para o usuário final.
- Um workflow genérico para invocar o BS de atribuição online;
- Workflow Policies para distribuição online
- Tarefas Batch para o Workflow Batch Process Manager
- Um BC de cadastro de Turnos e um BC de cadastro de funcionários no turno
- Duas configurações de candidatos dinâmicos no Workflow Object “Service Request”
- Três regras de Distribuição proporcional para candidatos dinâmicos (atende funcionalmente 20% das distribuições dos tipos de chamados do cliente)
- Uma Regra de Distribuição aleatória para candidatos dinâmicos (atende funcionalmente 80% das distribuições dos tipos de chamados do cliente)
- Uma Regra que mantém o dono atual (sem turno, mas com SR com dono).
De qualquer forma, como não queremos cansá-los, se você quiser ir direto ao assunto principal, pode pular diretamente para cá.
Workflow Genérico
O workflow genérico é o responsável, basicamente, por receber o Id do chamado (Service Request ou SR) e invocar o BS “Synchronous Assignment Manager Requests”.

Os dois últimos steps atendem o requisito de manter atualizados os níveis de propriedade do chamado que é um dos requisitos do Estudo de Caso. Estes não têm relação direta com o foco desse artigo.
O primeiro step apenas invoca o método “Assign” do business service “Synchronous Assignment Manager Requests” passando o Id do chamado como parâmetro. Isso é suficiente para acionar o componente “Assignment Manager”, de forma síncrona, e submeter o chamado ao “escrutínio” feito pelas engine de assignment manager.
Preferimos fazer o workflow desse jeitão simples e sem nenhum filtro ou regra funcional, pois isso nos dá a flexibilidade de montar essas regras antes de invocá-lo. Exemplos:
- Search expression de uma tarefa batch;
- Conditions de um workflow policy;
- Contitions de Run Time Events;
- etc.
Esse mesmo workflow pode ser invocado em contextos diferentes, para tipos de chamados diferentes, sob condições diferentes, on-line ou sob demanda. Basta passar o id do chamado como parâmetro que o workflow vai fazer o que tem que fazer: Chamar a engine de assignment manager do Siebel.
Workflow Policies
Podemos ter várias policies diferentes para chamar o Workflow Genérico que distribui os chamados.
A análise das condições para distribuir ou não um chamado fica à cargo de algum workmon on-line.
Usando workmons para a distribuição on-line, podemos paralelizar e escalar facilmente se altos volumes de chamados precisarem ser distribuídos.

Tarefas Batch
Uma das vantagens de usar esse approach é a possibilidade de programar as execuções batch de forma inteligente.
Ao invés de forçar um “reassignment” de chamados de hora em hora ou criando outra recorrência “burra” para garantir a troca de turnos, podemos criar tarefas para executarem apenas nos momentos onde, de fato, ocorram as trocas de turnos.
Exemplos:
- Se um determinado tipo de chamado é atendido por uma central que possui 3 turnos “irregulares” – um com 4 horas, outro com 6 horas e outro com 14 horas, por exemplo – podemos criar 3 tarefas distintas para executarem diariamente apenas nas faixas de horário onde ocorram as trocas de turnos.
- Se um determinado tipo de chamado é atendido por uma central que possui 3 turnos durante os dias úteis da semana e 2 turnos nos finais de semana, podemos criar 7 tarefas distintas para executarem, cada uma delas, semanalmente apenas nas faixas de horário onde ocorram as trocas de turnos.
Importante lembrar que, como nosso Workflow Genérico precisa de apenas 1 Object Id (Id do Chamado) como input, os agendamento devem ser feitos para o componente Workflow Process Batch Manager.
Como vocês sabem:
- O Workflow Process Batch Manager monta um cursor de Ids com base na query feita no Business Component principal do Business Object do Workflow Genérico usando o Search Specification passado como parâmetro no scheduler nos critérios de pesquisa
- Passa cada um dos Ids retornado no cursor para uma instância (tarefa) de Workflow Process Manager processar isoladamente.
Se usássemos o componente Workflow Process Manager no agendamento das tarefas batch, a query da chamados precisaria ser feita “hardcoded” no próprio workflow. Isso tiraria flexibilidade da solução, exigiria a criação de N workflows distintos que na prática fariam a mesma coisa para conjunto de registros diferentes.
O Workflow Process Batch Manager endereça esse problema.

Business Components Customizados
Aqui é o feijão com arroz de qualquer desenvolvedor Siebel:
- Um BO, um BC pai onde cadastramos as informações do Turnos tais como:
- Tipo de Chamado e Status do Chamado – Para linkarmos o turno ao chamado;
- Horário de Início e Término do Turno – Para selecionarmos o turno correto dependendo do horário;
- Dias da Semana onde o Turno é Válido – Para permitir criar turnos específicos para dias da semana específicos, como nos finais de semana;
- Um flag de Ativo ou Inativo – Para desativar e reativar turnos inteiros se for necessário.
- Um link e um BC Filho onde associamos os usuários aos turnos e podemos remover, ativar ou desativar usuários de um turno
- Applets para cadastrar essas novas entidades.

Os dias da semana são um dos seletores de um turno. Para atender esse critério, criamos uma LOV simples que mapeia os dias da semana por número, da mesma forma que a função do Oracle SQL “TO_CHAR(SYSDATE,’D’)“.
Mais adiante a inclusão de números identificando os dias da semana vai fazer mais sentido.

Configurações de Candidatos Dinâmicos

Vamos começar explicando o candidato dinâmico “Atual Owner”, pois entendendo como ele funciona fica muito mais fácil entender os candidatos dinâmicos de “Turno – Tipo SR – Status SR”. Vejamos:

No exemplo acima, a query para selecionar o(s) candidatos dinâmicos ficaria assim (coloquei comentários em azul):
SELECT A2.OWNER_EMP_ID -- Candidate Id ColumnFROM OWNER.S_SRV_REQ A1, -- Primary tableOWNER.S_SRV_REQ A2 -- Candidate tableWHERE A1.ROW_ID = '1-23456' -- A Primary Table faz constraint com o ROW_ID do objeto a ser atribuído, ou seja, "1-23456" representa o ROW_ID do chamado (Service Request) que será atribuído.A1.ROW_ID = A2.ROW_ID AND -- Relacionamento entre as tabelasA1.OWNER_EMP_ID IS NOT NULL -- Additional Join Spec
Não é preciso ser um expert em SQL para perceber que a query acima vai retornar, no máximo, uma linha, pois temos um autorelacionamento da tabela S_SRV_REQ pela chave primária ROW_ID.
Como o próprio nome “Atual Owner” do candidato dinâmico sugere, o objetivo dele é não alterar o atual owner do chamado conforme o item 10 do estudo de caso que esse artigo busca elucidar.
Na ordem de busca do melhor candidato para um chamado, nossa solução só passa por esse candidato dinâmico em especial, se não achar nenhum grupo de candidatos nas regras que são analisadas primeiro. Trata-se de um artifício para não remover o dono do chamado e atribuí-lo ao SADMIN caso ele já tenha dono.
Agora vejamos nossa configuração de candidatos dinâmicos mais complexa, aquela que vai buscar nas tabelas de turno e de usuários associados ao turno os candidatos.

A transcrição das colunas “Additional Join Spec”, que ficou cortada no print, ficou assim:
((TO_NUMBER(TO_CHAR(SYSDATE,’HH24′)) BETWEEN [A2].X_TURNO_START AND [A2].X_TURNO_END) OR (([A2].X_TURNO_START-[A2].X_TURNO_END>0) AND (TO_NUMBER(TO_CHAR(SYSDATE,’HH24′))<=[A2].X_TURNO_END OR TO_NUMBER(TO_CHAR(SYSDATE,’HH24′))>=[A2].X_TURNO_START)))
[A3].X_FLG_STS=’Y’ AND (INSTR([A2].X_DIAS_NUM, TO_CHAR(SYSDATE,’D’)) > 0) AND ([A2].X_FLG_STATUS=’Y’ OR [A2].X_FLG_STATUS IS NULL)
DECODE([A1].INS_PRODUCT,’TIPO1′,’TIPO2′,[A1].INS_PRODUCT) = [A2].X_TIPO_SR GROUP BY [A3].PAR_ROW_ID, [A2].X_CENTRAL, [A2].X_STATUS_SR, [A2].X_TIPO_SR
A query gerada a partir daí é exatamente como (comentários em azul):
SELECT A3.PAR_ROW_ID, -- Candidate Id ColumnFROM SIEBEL.S_SRV_REQ A1, -- Primary TableSIEBEL.CX_ASGN_SCHED A2, -- Tabela onde configuramos os turnosSIEBEL.CX_ASGN_CONFIG A3 ,-- Intertable TurnoXUsuárioSIEBEL.S_SRV_REQ_X A4 -- Precisávamos de mais cláusula WHERE, pois o "Additional Join Spec" tem um limite de 255 caracteres. Criamos uma tabela e um join que não altera o resultado da query.WHERE A1.ROW_ID = '1-23456' AND -- Id do Objeto sendo passado para a Primary tableA2.X_STATUS_SR = A1.SR_STAT_ID AND -- Join simples A1/A2((TO_NUMBER(TO_CHAR(SYSDATE,'HH24')) BETWEEN A2.X_TURNO_START AND A2.X_TURNO_END) OR ((A2.X_TURNO_START-A2.X_TURNO_END>0) AND -- Garante que o turno cobre o horário atual(TO_NUMBER(TO_CHAR(SYSDATE,'HH24'))<=A2.X_TURNO_END OR TO_NUMBER(TO_CHAR(SYSDATE,'HH24'))>=A2.X_TURNO_START))) AND -- Garante que o turno cobre o horário atualA3.X_TURNO_ID = A2.ROW_ID AND -- Join simples A2/A3A3.X_FLG_STS='Y' AND -- Garante que o usuário está ativo no turno(INSTR(A2.X_DIAS_NUM, TO_CHAR(SYSDATE,'D')) > 0) AND -- Garante que o turno cobre o dia da semana atual (lembra do pickmap da LOV que falamos aqui)(A2.X_FLG_STATUS='Y' OR A2.X_FLG_STATUS IS NULL) AND -- Garante que o turno está ativoA4.ROW_ID = A1.ROW_ID AND -- Join simples A1/A4 -Primary table X tabela estendida . Join feito apenas para termos mais Additional Join Specs para escreverDECODE(A1.INS_PRODUCT,'TIPO1','TIPO2',A1.INS_PRODUCT) = A2.X_TIPO_SR -- Existem 2 tipos de chamado que funcionalmente são apenas 1, por isso esse DECODEGROUP BY A3.PAR_ROW_ID, A2.X_CENTRAL, A2.X_STATUS_SR, A2.X_TIPO_SR -- Agrupa o resultado para evitar duplicações, pois mais de um turno pode cobrir o mesmo horário/dia da semana e um mesmo usuário pode estar em mais de um grupo. Aqui há o merge mencionado no item 8.
O legal aqui é entender a flexibilidade que a engine dispõe ao ao utilizar comandos de SQL capazes de filtrar, agrupar, ordenar e transcrever registros no nível do database.
Perceba que uma grande parte das regras funcionais foram incorporadas numa query simples usando poucas tabelas. Isso é poder de seleção de candidatos com desempenho de avaliação altíssimo!
Regras de Atribuição
O restante das regras funcionais que ainda faltavam ser contempladas, o foram com:
- Três regras de atribuição, todas considerando o grupo de candidatos dinâmicos mais complexo (Turno / Tipo SR / Status SR) distribuído proporcionalmente com base em regras de distribuição de carga de trabalho e um melhor ajuste.
- Poderia ser uma regra ou dezenas delas.
- O que determina a quantidade de regras é a quantidade de grupos de Services Requests que precisam ser contadas por usuário para determinar a proporcionalidade.
- Nesse caso de uso, eram 3 combinações de Tipo/Status que precisavam ser contadas, por isso, apenas 3 regras.
- Uma regra de atribuição, considerando o grupo de candidatos dinâmicos mais complexo (Turno / Tipo SR / Status SR), associada com distribuição aleatória entre os candidatos dinâmicos
- Para as distribuições que não precisavam ser proporcionais.
- Grandes volumes de chamados distribuídos aleatoriamente, mesmo num curto prazo, quase não desviam da proporcionalidade.
- Um “coroa na moeda” jogado 3x gera 33% de discrepância entre os resultados. Jogado 10.000 x o desvio tende a ser bem mais baixo.
- Uma rega de atribuição, considerando o candidato dinâmico mais simples (Atual Owner). Como o candidato dinâmico dessa regras retorna no máximo 1 user, a distribuição pode ser aleatória.
As cinco regras precisam estar ordenadas de maneira estratégica, pois cada uma delas serve apenas de transbordo para a regra seguinte, ou seja, se a primeira regra for analisada e descartada, a segunda passa ser avaliada, e assim, por diante.
Da mesma forma, assim que uma das cinco regras for analisada e considerada, se a mesma retornar candidatos dinâmicos, as demais não serão sequer avaliadas. Ganhamos muito em performance dispondo as regras de forma estratégica (maior volume de chamados retornando nas primeiras regra, por exemplo).
A configuração de exclusividade de uma regra de atribuição é feita através da flag “Exclusivo” das regras que devem ter esse comportamento. Se a flag não for marcada, para uma regra, o resultado da avaliação dessa regra é comparado com o resultado da avaliação da regra seguinte podendo gerar um resultado diferente daquele que buscamos dentro deste caso de uso.
Na nossa solução, a única regra que não é exclusiva é a última delas, pois, caso uma das quatro regras anteriores seja avaliada, considerada, mas não retorne candidatos válidos, nós precisamos garantir que não iremos alterar o dono atual do chamado. Para isso, forçamos uma atribuição “fake” que não gera mudança no chamado caso ele já tenha dono.


SELECT COUNT(*) -- Contagem
FROM SIEBEL.S_SRV_REQ T0 -- Tabela principal do Objeto de Atribuição/Assignment Object
WHERE T0.SR_STAT_ID = 'STATUS QUALQUER' AND -- Campo condicional (Operador) Valor
T0.INS_PRODUCT IN ('QUALQUER 1', 'QUALQUER 2') AND -- Campo condicional (Operador) Valor
T0.OWNER_EMP_ID = ? AND -- Id de cada um dos candidatos dinâmicos
T0.ROW_ID <> ? -- Id do objeto que se quer atribuir, para removê-lo da contagem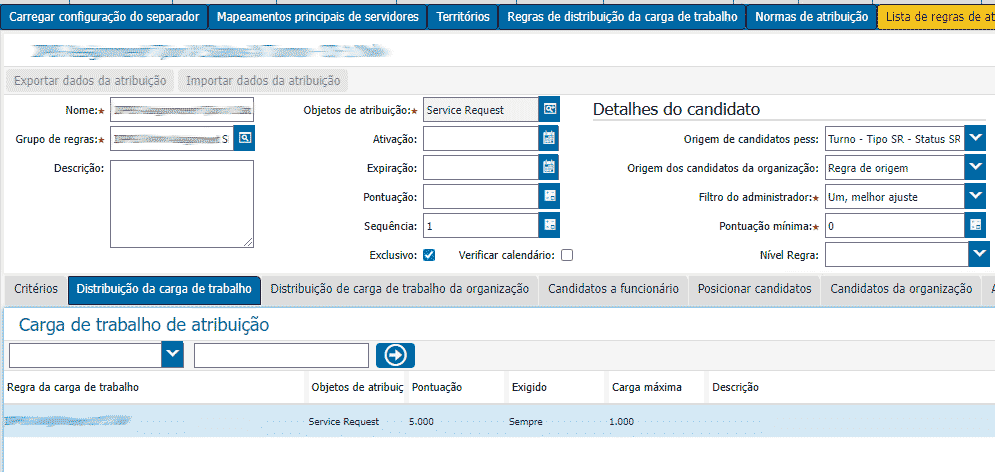
A Oracle chama de “Workload Score” a pontuação da carga de trabalho que é atribuída para cada candidato em função de cada uma das regras de carga de trabalho que são associadas a uma regra de distribuição. A fórmula é a seguinte:
Workload Score = Pontuação * (1 – Carga Atual / Carga Máxima)
A Carga Atual, quem determina é esse “count” que vimos aqui.
Suponhamos que o “count” retornou 950 linhas para o candidato A e 962 linhas para o candidato B e 1002 linhas para o candidato C, teríamos:
candidato A >>> Workload Score = 5000 * (1 – 950/ 1000) = 250
candidato B >>> Workload Score = 5000 * (1 – 962 / 1000) = 190
candidato C >>> Workload Score =nem é calculado porque o candidato C tem mais registros que o definido no campo “Carga Máxima”.
Perceba que:
- O candidato A que tem menos registros retornando no “count” da regra de carga de trabalho recebe uma pontuação maior que o candidato B.
- O candidato C que está atolado de trabalho e tem um “count” de carga de trabalho acima da Carga Máxima definida, é descartado.
- Quanto menor a carga de trabalho de um candidato, mais próximo o Workload Score dele da Pontuação definida em 5000.
Em suma, se a regra for selecionada para o chamado que está sendo atribuído, o mesmo seria atribuído ao candidato A que recebeu uma pontuação maior.
Agora, pensa comigo, por que usar uma pontuação de 5000 nesse caso concreto e não 100, 10, 50, 10000 ou outro número qualquer?
A resposta é mais simples do que parece: Porque, se tivermos mais de uma regra de carga de trabalho numa mesma regra de distribuição, temos a flexibilidade de dar mais peso para algumas e menos peso para outras.
Com mais de uma regra de carga de trabalho numa mesma regra de atribuição, a mesma fórmula seria feita usando outras variáveis levando a outro resultado que seria somado com os resultados anteriores. No final, o candidato com pontuação maior é o mais “sussa” para receber o chamado por causa do filtro “Um melhor ajuste”.
Por exemplo, vamos dizer que, além da quantidade de chamados já atribuídos para cada candidato, eu quisesse contar a quantidade de Atividades pendentes (Action com Status=Pendente), mas a quantidade de atividades tem um peso 2x maior, porque, digamos, apesar da média de atividades pendentes de um usuários ser baixa, o trabalho real empreendido na resolução de uma atividade pendente é muito superior ao trabalho para fechamento de um chamado.
Poderíamos ter:
| Regra de carga de trabalho | Pontuação | Carga Máxima | Carga Atual | Workload Score Pontuação * (1 – Carga Atual / Carga Máxima) |
| Conta Chamados | 5000 | 1000 | 600 | 2000 |
| Conta Atividade | 10000 | 20 | 12 | 4000 |
| Workload Score Total | 6000 |
Perceba que o ratio da Pontuação sobre a Carga Máxima influencia diretamente o resultado do Workload Score, seja para números mais granulares e altos ou números mais concisos e baixos.
| Pontuação | Carga Máxima | Carga Atual hipotética | Workload Score |
| 5000 | 15 | 10 | 1.667 |
| 4000 | 15 | 10 | 1.333 |
| 2000 | 15 | 10 | 667 |
| 1000 | 15 | 10 | 333 |
| 100 | 15 | 10 | 33 |
| 10 | 15 | 10 | 3 |
| Dados Reguladores/Arbitrários | Dados Absolutos/Encontrados no Mundo Real | Resultado com Base na Pontuação | |
Por isso a Pontuação, por ser uma valor arbitrário sem correspondente no mundo real, funciona como um regulador para o Workload Score, esse sim com impactos práticos no mundo real.
Concluindo
O uso dos candidatos dinâmicos. quando feito da forma correta e estratégica, endereça de maneira simples uma boa parte dos requisitos das regras para distribuição de registros.
As regras de negócio que não tiverem relação direta com os candidatos vão ser endereçadas:
- Filtros dos processos que invocam a engine de Assignment Manager para distribuir um registro qualquer (search expr de um Workflow Batch, run time event, policy criteria de um Workflow Policy, etc.)
- Ordenação das regras de distribuição e correta marcação das flags de exclusividade quando for conveniente
- Construção de regras de carga de trabalho performáticas.
- Configuração adequada das regras de distribuição em função das regras de carga de trabalho.
Nesse cliente aqui, resolvemos um problemão e economizamos uma tremenda grana. Esperamos que algo tirado daqui também seja útil para você.
Abraço.